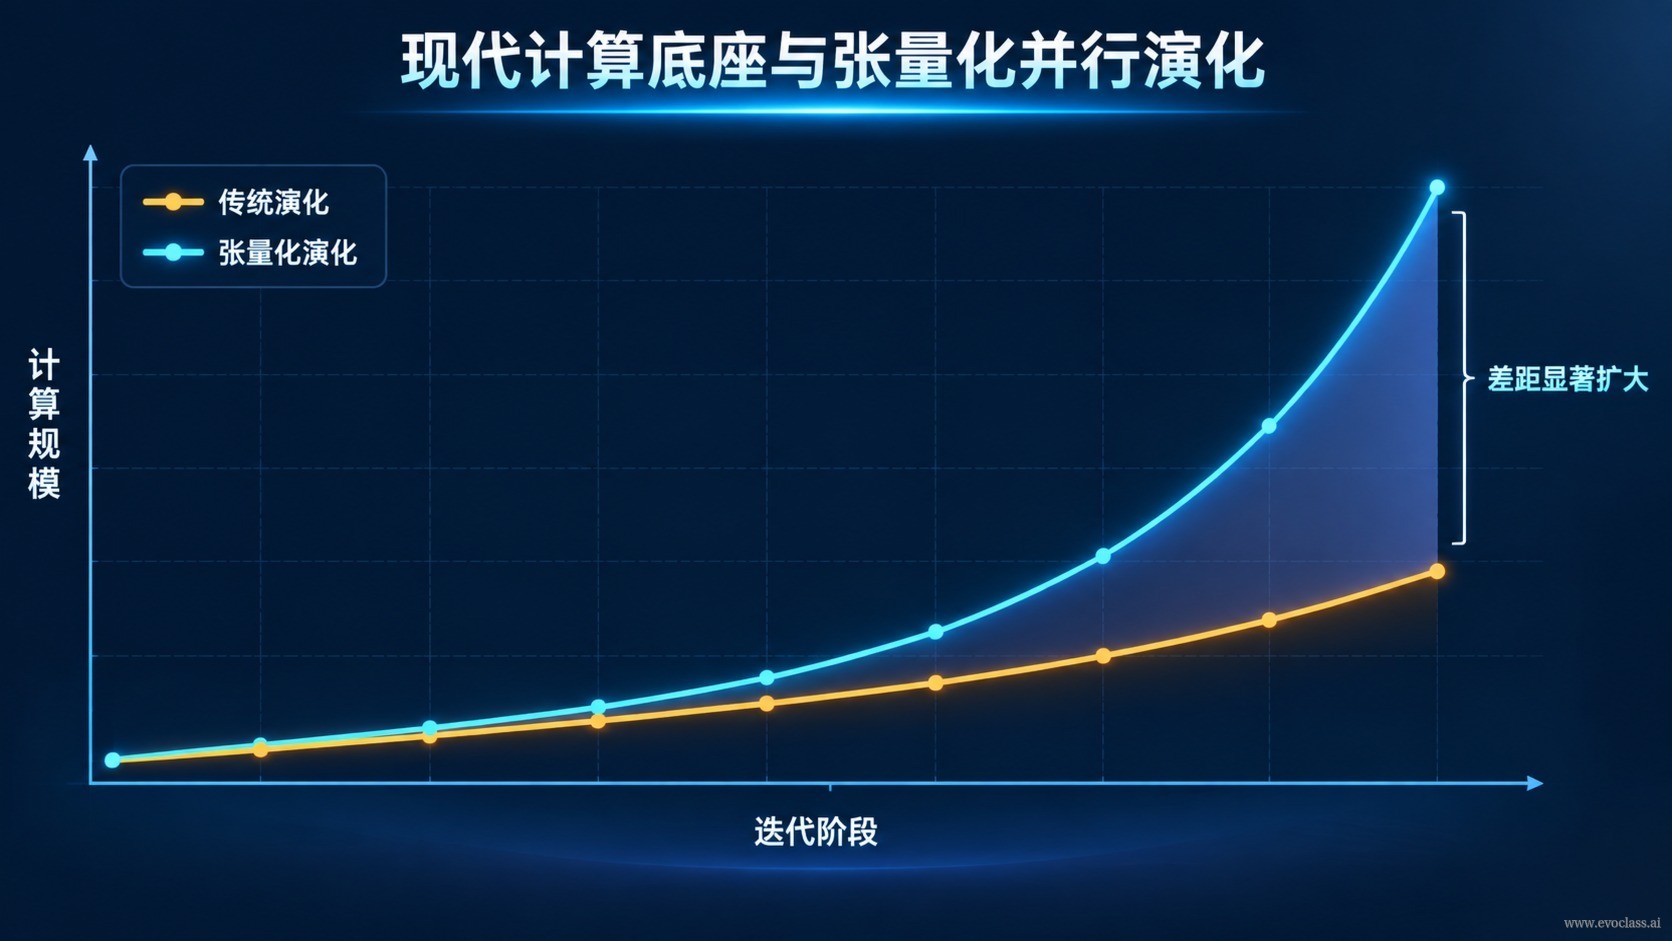
現代演化計算面對一個結構性矛盾:演化的有效性依賴種群多樣性,而多樣性會直接轉化為評價次數、狀態管理與調度成本;傳統以 CPU 迴圈逐個體執行的方式,很快就會在吞吐上觸頂。現代計算底座的應對方式,是把種群、評價與狀態重新組織成可整體計算的張量,用 GPU 上的批量並行取代逐個體迴圈,從而在同一輪內同時推進大量候選。
為什麼串行迴圈會先觸頂
在串行實現中,一次迭代需要為每個個體單獨呼叫目標函數、單獨更新狀態、單獨記錄日誌。當種群規模從數十增長到上千時,評價次數按規模線性增長,牆鐘時間也幾乎同樣線性增長;一旦單次模擬(例如高精度氣動計算)代價高昂,整體吞吐就被鎖死在「單核節奏」上。多樣性越高、評價越貴,串行瓶頸就越明顯。
張量化:把種群、評價與狀態組織成張量
- 種群張量:把全部候選的參數堆疊成二維張量(個體數 × 維度),一次算子呼叫即完成全種群的變異與更新,而不是逐個迴圈。
- 評價張量:把批量評價請求打包下發,由 GPU 或批次處理服務並行執行後合併返回值。
- 狀態張量:把適應度、約束違背量、排名等中間狀態以張量形式維護,使選擇、排序與更新都能整體計算。
- 批量並行:以上三點合起來就是本頁的核心術語——批量並行。它把「多樣性帶來的計算量」從負擔變成可被吞吐吸收的規模,因此不是最佳化細節,而是現代演化計算的基礎設施問題。
大模型把候選生成推到新的邊界
當計算規模被打開後,關鍵問題就從「能不能算」轉向「候選從哪裡來」。大模型能理解自然語言、程式碼、領域知識與專案上下文,並據此建構結構複雜的候選,使演化對象從一組數值參數擴展到程式、演算法乃至完整系統狀態。過去依賴人工設計的編碼與變異方式,開始可以由模型參與生成。兩股力量由此相遇:GPU 讓大量可能被同時探索,大模型讓系統產生更豐富的可能,而演化機制則把候選送入真實任務,透過執行與評價決定哪些變化值得保留。
一次系統級架構取捨
對演算法工程師與系統開發者而言,上述變化帶來的不是局部最佳化,而是架構取捨:需要在候選生成的豐富性、批量計算的吞吐與工程複雜度之間做系統級權衡。多樣性是演化有效性的前提,但它必須由吞吐來消化。
EvoX 場景範例
若仍使用串行 CPU 迴圈逐個體評價,種群規模會被吞吐限制;改為張量化批量並行後,同一輪即可同時組織大量候選的參數、評價狀態與更新,使「保持多樣性」與「大規模探索」在工程上同時可行。
串行與張量化並行對比折線圖對比傳統串行演化與張量化批量並行的計算規模:傳統 CPU 逐個體評價時,評價次數和牆鐘時間隨種群規模近線性增長,遇到昂貴模擬便先觸頂;張量化把種群、評價與狀態組織成張量,在 GPU 上同輪推進大量候選,使多樣性與大規模探索同時可行。大模型則進一步擴展候選生成的邊界。
串行與張量化並行對比
折線圖對比傳統串行演化與張量化批量並行的計算規模:傳統 CPU 逐個體評價時,評價次數和牆鐘時間隨種群規模近線性增長,遇到昂貴模擬便先觸頂;張量化把種群、評價與狀態組織成張量,在 GPU 上同輪推進大量候選,使多樣性與大規模探索同時可行。大模型則進一步擴展候選生成的邊界。